Oleh Pesach Benson • 16 November 2026
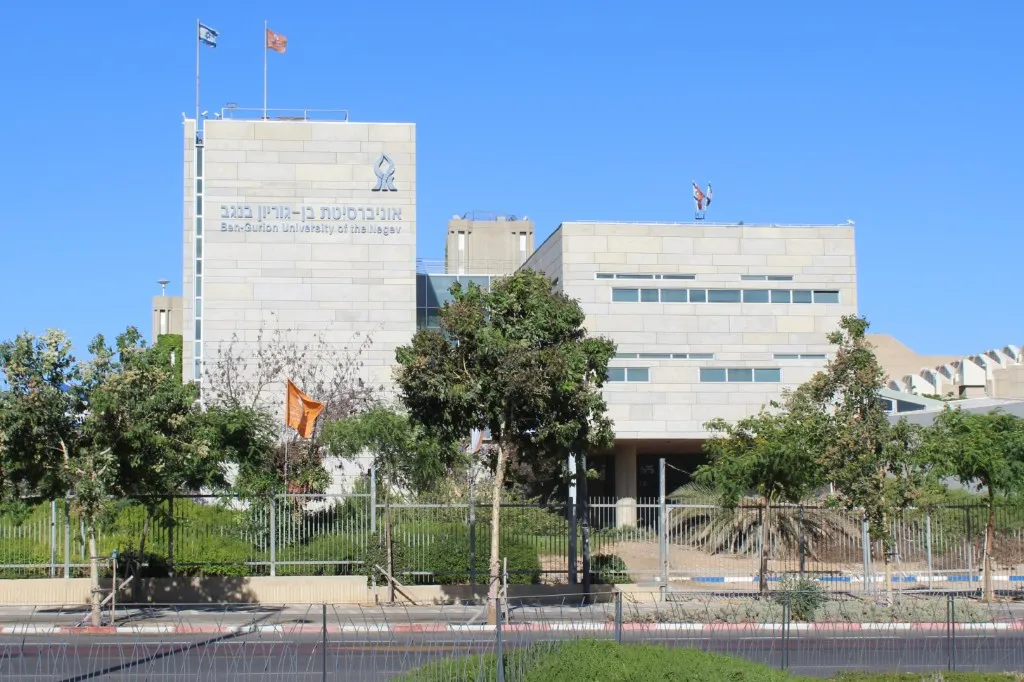
Yerusalem, 16 November 2026 (TPS-IL) — Sebuah studi baru yang dipimpin oleh Ben-Gurion University of the Negev telah mengungkap kerentanan dalam sistem pemindaian digital yang digunakan produsen DNA sintetis. Studi ini memperingatkan bahwa sekuens genetik yang berpotensi berbahaya dapat disamarkan dan dipesan secara daring dengan membaginya menjadi fragmen-fragmen lebih kecil yang tampak tidak berbahaya.
Para peneliti juga mengembangkan algoritma baru yang dirancang untuk mengidentifikasi ancaman tersembunyi semacam itu, menawarkan potensi peningkatan pada langkah-langkah biosekuritas seiring rekayasa genetika yang kian mudah diakses.
DNA yang dibuat secara khusus (custom-made) banyak digunakan oleh universitas, perusahaan farmasi, dan perusahaan bioteknologi untuk mengembangkan obat-obatan, mempelajari penyakit, merekayasa mikroorganisme, dan memproduksi protein. Namun, teknologi ini juga menimbulkan tantangan biosekuritas: sistem pemesanan yang sama berpotensi dieksploitasi untuk memperoleh materi genetik yang dapat digunakan untuk menghasilkan zat biologis berbahaya.
Temuan yang diterbitkan dalam jurnal tertelaah sejawat Nature Communications ini menyoroti tantangan yang dihadapi industri tempat pelanggan dapat memesan sekuens DNA khusus secara daring dan mengirimkannya langsung ke laboratorium mereka.
Perusahaan DNA sintetis secara rutin memindai pesanan pelanggan untuk mendeteksi sekuens yang terkait dengan agen biologis berbahaya, termasuk toksin. Namun, standar pemindaian yang ada saat ini umumnya mengharuskan sekuens mencurigakan melampaui panjang minimum, biasanya 50 blok pembangun genetik berurutan yang dikenal sebagai nukleotida.
Para peneliti yang dipimpin oleh Prof. Rami Pozis dan Prof. Isana Wexler-Lublinsky menemukan bahwa persyaratan ini menimbulkan celah potensial. Dengan membagi sekuens berbahaya menjadi fragmen-fragmen yang lebih pendek, pelaku penyerang dapat menghindari deteksi karena tidak ada satu pun fragmen yang melampaui ambang batas pemindaian. Setelah terkirim, fragmen-fragmen tersebut berpotensi dirakit kembali menggunakan teknik laboratorium standar untuk menciptakan ulang sekuens penghasil toksin yang asli.
‘Penyerang Kian Canggih’
Tim peneliti mengembangkan algoritma bernama Gene Edit Distance (GED) untuk mengatasi kerentanan tersebut. Alih-alih memeriksa setiap fragmen DNA secara independen, algoritma ini mengevaluasi apakah beberapa fragmen dalam suatu pesanan dapat digabungkan atau dimodifikasi untuk menghasilkan sekuens toksik yang sudah dikenal.
“Penyerang kian canggih, sehingga sistem pertahanan juga harus maju menyesuaikannya,” kata Shaked Tiuri-Atia, mahasiswa magister yang memimpin penelitian ini.
“Alih-alih hanya melihat setiap segmen secara individual dan menanyakan ‘Apakah ini beracun?’, algoritma GED memperkirakan ‘upaya’ yang diperlukan seorang ahli biologi untuk merakit kembali racun tersebut di laboratorium. Sudut pandang luas inilah yang memungkinkan kita memblokir ancaman yang disamarkan,” jelasnya.
Untuk menguji kemampuan pemindaian yang ada, para peneliti membuat basis data sekuens toksin dan menerapkan tiga strategi penyamaran: menyisipkan DNA tak berbahaya di antara fragmen, mengatur ulang atau membalik fragmen, dan mendistribusikan fragmen ke beberapa struktur genetik dalam satu pesanan.
Mereka kemudian mengevaluasi dua perangkat pemindaian komersial, sistem sumber terbuka SeqScreen, perangkat penyelarasan sekuens BLAST yang banyak digunakan, serta algoritma GED mereka terhadap sekuens toksin yang disamarkan dan yang tidak diubah, serta sekuens genetik yang tidak berbahaya.
Sistem komersial dan SeqScreen umumnya mendeteksi ancaman ketika setidaknya satu fragmen melebihi 50 nukleotida, konsisten dengan pedoman regulasi saat ini. Namun, tiga sekuens yang mengandung fragmen lebih panjang dari ambang batas tersebut lolos dari deteksi. Perusahaan yang bertanggung jawab atas perangkat pemindaian tersebut sedang menyelidiki perbedaan ini.
BLAST kesulitan membedakan antara sekuens yang tidak berbahaya dan sekuens toksin yang disamarkan. Sebaliknya, GED mencapai akurasi 100 persen dalam memisahkan kedua kelompok tersebut, tanpa menghasilkan positif palsu, menurut studi tersebut.
Para peneliti mengatakan algoritma ini juga menjawab tantangan besar dalam memindai fragmen DNA pendek: banyak sekuens pendek muncul secara alami dan tidak berbahaya. Dengan menggabungkan beberapa fragmen menjadi kueri yang lebih panjang, GED dapat mengidentifikasi potensi ancaman sekaligus mengurangi alarm palsu.
“Penelitian ini merupakan contoh uji penetrasi proaktif, yang bertujuan memeriksa kerentanan keamanan dan memungkinkan perusahaan bioteknologi memperbaikinya sebelum pihak-pihak yang bermusuhan mulai mengeksploitasinya,” kata Prof. Pozis.
Para peneliti telah membagikan basis data sekuens tersembunyi mereka kepada organisasi internasional, termasuk International Gene Synthesis Consortium (IGSC) dan Synthetic Biology Research Consortium (SBRC), untuk membantu meningkatkan standar pemindaian industri.
“Pesannya jelas: semakin biologi mudah diakses publik, semakin ketat pula selubung pelindung digitalnya,” tutur Pozis.
Kode sumber algoritma GED telah disediakan untuk umum.